En el vertiginoso mundo de la inteligencia artificial, la estabilidad y la eficiencia son cruciales. Con la aparición constante de nuevos modelos y la mejora de los existentes, depender de un solo proveedor de IA se ha convertido en una estrategia arriesgada. Eventos como limitaciones de tasa, caídas de rendimiento o cambios inesperados en los precios pueden dejar tu aplicación sin un plan de contingencia. Por ello, la implementación de un enrutador de IA multi-modelo con capacidad de fallback automático es una solución indispensable para cualquier equipo de ingeniería.
¿Por qué un enrutador de IA es esencial ahora mismo?
El panorama de los modelos de IA en la actualidad es dinámico. Recientemente, hemos visto el lanzamiento simultáneo de modelos insignia de los principales laboratorios de IA: GPT-6 Astra de OpenAI, Claude Fable 5.1 de Anthropic, Gemini 3.8 Flash de Google y V4.1 Flash de DeepSeek. Esta intensa competencia subraya la necesidad de una infraestructura flexible. Un modelo que hoy es líder en rendimiento o costo, podría no serlo mañana.
Considera estos escenarios:
- Una saturación inesperada del servicio que activa límites de tasa.
- Una interrupción parcial del servicio que dura horas.
- Un aumento repentino en los precios que vuelve obsoleto tu modelo de costos.
En cualquiera de estos casos, una aplicación configurada para un único API está en desventaja. Un enrutador no previene estos eventos, pero transforma una posible interrupción crítica en un simple registro en un archivo de logs, permitiendo que tu aplicación continúe funcionando sin problemas.
LiteLLM: La base para tu enrutador
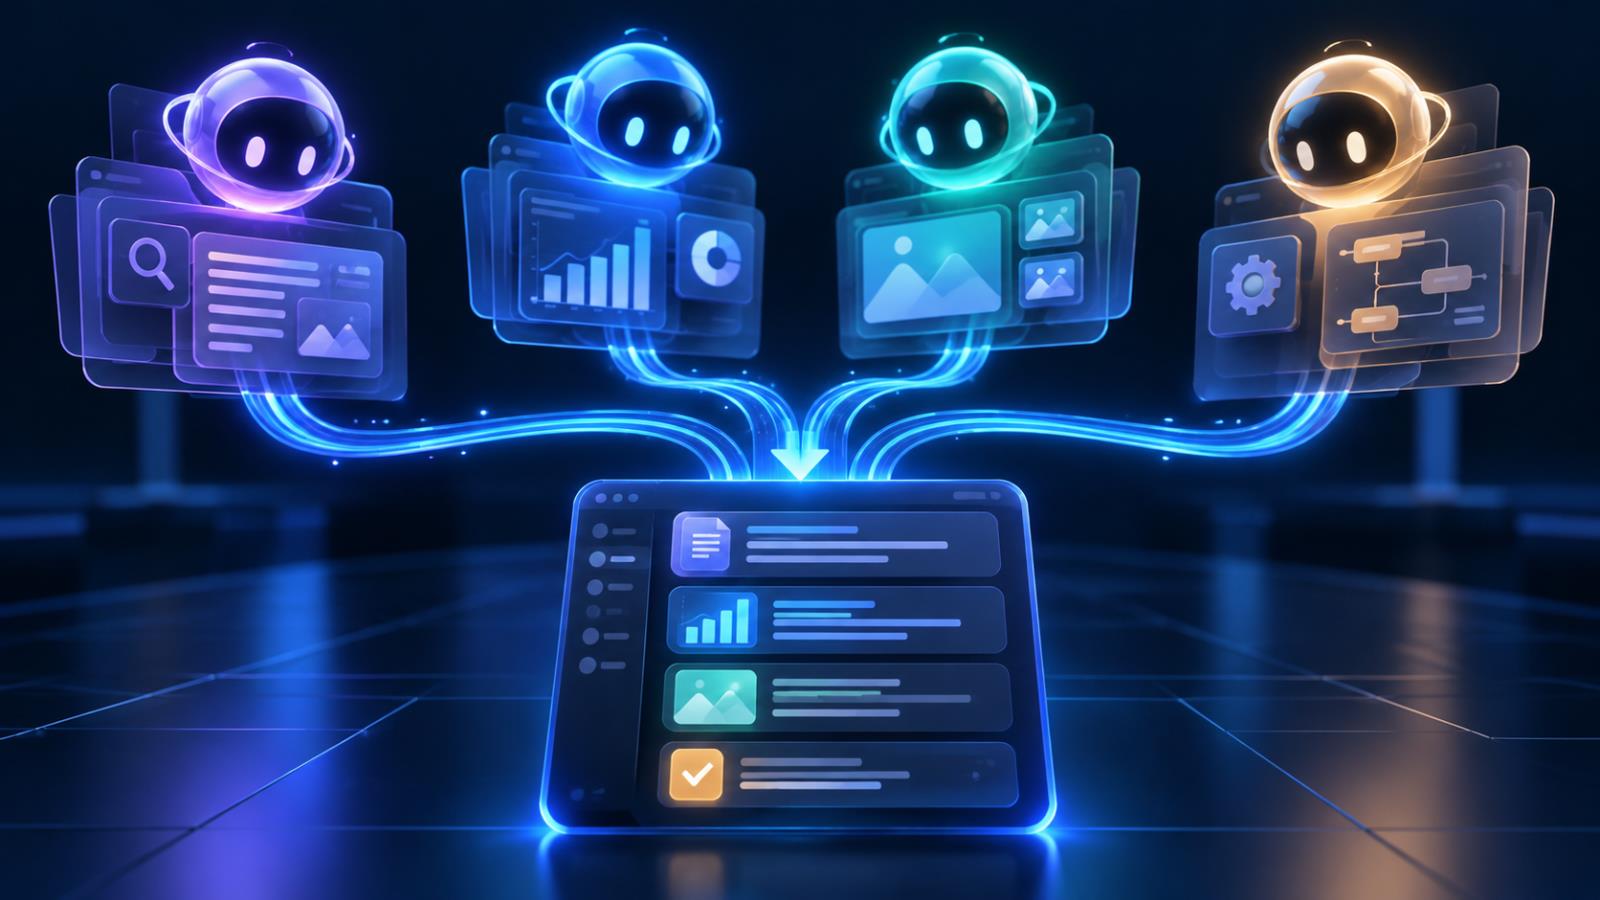
Este tutorial te guiará a través de la construcción de un enrutador de IA multi-modelo utilizando la biblioteca de código abierto LiteLLM. Esta herramienta te permite abstraer la complejidad de interactuar con múltiples APIs de modelos, proporcionando una interfaz unificada. El objetivo es que tu aplicación pueda, por ejemplo, intentar primero con GPT-6 Astra, y si OpenAI aplica límites de tasa, automáticamente recurrir a Claude Fable 5.1. Además, puedes configurar el sistema para usar modelos más económicos como Gemini 3.8 Flash o DeepSeek V4.1 Flash para solicitudes de alto volumen y menor criticidad, todo sin modificar el código de tu aplicación.
Pasos clave para construir tu enrutador
La implementación de un enrutador robusto implica varias etapas críticas:
- Mapeo de modelos y selección de proveedores: Define qué modelos y proveedores se adaptan mejor a tus necesidades en términos de rendimiento, costo y disponibilidad.
- Configuración de LiteLLM: Instala la biblioteca y configura tu proyecto.
- Gestión segura de claves API: Almacena tus credenciales de forma segura.
- Definición de rutas y alias de modelos: Crea reglas para dirigir el tráfico a los modelos adecuados.
- Construcción de cadenas de fallback: Establece el orden de preferencia entre los modelos para asegurar la continuidad del servicio.
- Enrutamiento consciente de costos y latencia: Optimiza la selección del modelo basándose en estos criterios.
- Configuración de reintentos, tiempos de espera y disyuntores: Implementa mecanismos de tolerancia a fallos.
- Balanceo de carga: Distribuye las solicitudes entre múltiples claves API y regiones para maximizar la disponibilidad.
- Registro de solicitudes y seguimiento de gastos: Monitorea el uso y los costos asociados.
- Despliegue y monitoreo: Pon en marcha tu enrutador en producción y asegúrate de supervisar su rendimiento.
Al finalizar este proceso, tendrás un servidor proxy funcional que te permitirá gestionar de manera eficiente y resiliente la interacción con múltiples modelos de IA, protegiendo tu aplicación de las interrupciones y optimizando los recursos.
Un enrutador de IA transforma un incidente crítico en un simple registro, asegurando la continuidad operativa de tus aplicaciones.
La capacidad de alternar entre modelos no solo mejora la resiliencia, sino que también te ofrece flexibilidad para adaptarte rápidamente a las innovaciones del mercado y a las fluctuaciones de precios, manteniendo siempre la mejor relación costo-beneficio para tus operaciones.