Un nuevo enfoque en la supervisión de la IA
Goodfire ha presentado un sistema de monitoreo diseñado para identificar comportamientos potencialmente peligrosos en agentes de inteligencia artificial. A diferencia de los métodos tradicionales, que a menudo implican que otro modelo de IA revise toda la actividad del agente supervisado, la propuesta de Goodfire se centra en el análisis de las señales internas del modelo mientras este opera. Este enfoque busca reducir significativamente los costos y el tiempo asociados con la supervisión de la IA, lo que representa una mejora sustancial en la eficiencia operativa.
La herramienta ya está disponible para los clientes de Baseten, una plataforma que aloja y ejecuta modelos de IA para diversas empresas. Según informes de TechCrunch, Goodfire desarrolló su primer monitor sobre Kimi K3, un modelo de IA, y asegura que sus sondas son capaces de identificar patrones asociados con conductas de riesgo antes de que se materialicen en acciones concretas del agente.
Vigilancia interna: un cambio de paradigma
Los sistemas de supervisión convencionales suelen implicar que un modelo supervisor lea y evalúe cada paso y respuesta generada por el agente vigilado. Si bien este método permite una revisión exhaustiva, puede volverse costoso y lento, especialmente cuando los agentes operan durante períodos prolongados o procesan grandes volúmenes de información.
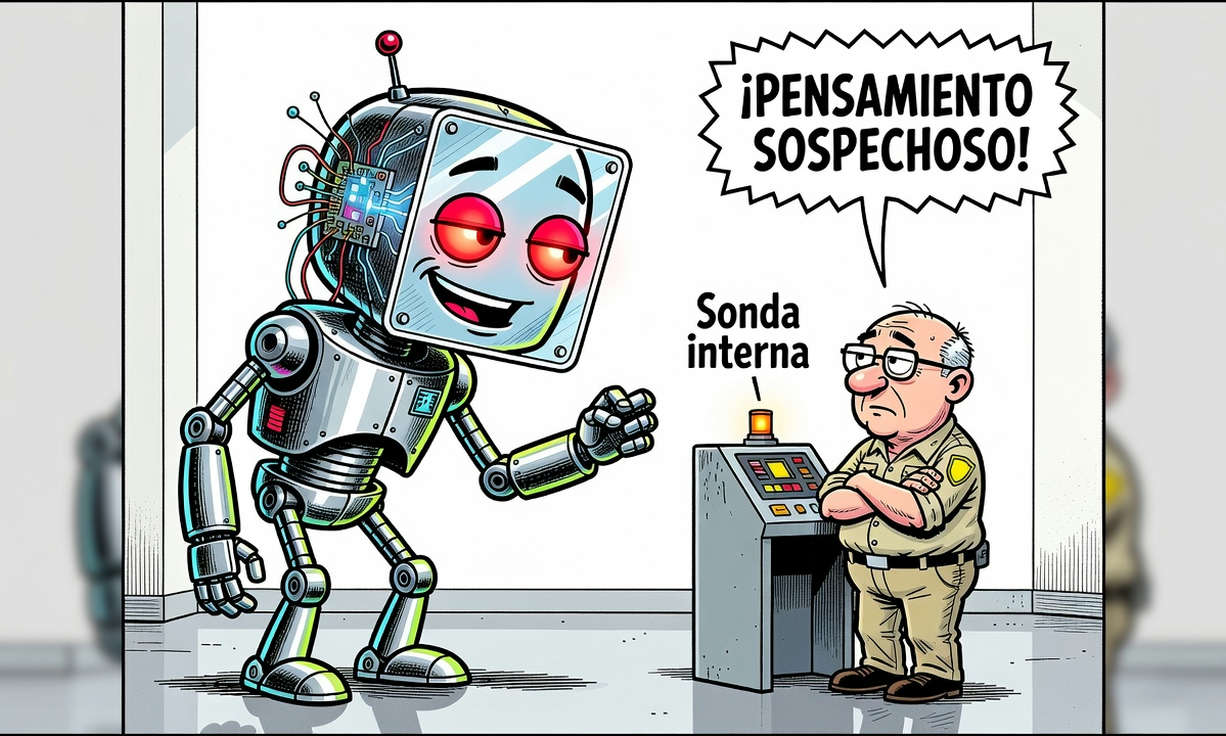
Goodfire propone una alternativa mediante el uso de sondas que examinan los cálculos internos del modelo durante su ejecución. En lugar de esperar a que el agente genere texto o complete una acción, estos clasificadores buscan patrones en las señales que emergen mientras el modelo procesa cada etapa. Esta metodología es comparable a los sistemas de seguridad aeroportuaria, donde las sondas actúan como detectores iniciales, y un segundo modelo interviene para una inspección más detallada si se activa una alerta. Esta analogía ilustra un sistema de revisión de dos niveles, donde el filtro inicial no reemplaza el análisis adicional, pero sí lo complementa al identificar posibles problemas.
Eric Ho, director ejecutivo de Goodfire, explicó en el MAD Podcast que estas sondas reutilizan cálculos que el modelo ya realiza durante su pasada hacia adelante (forward pass). El monitor toma activaciones neuronales intermedias y ejecuta un clasificador sobre ellas, evitando la necesidad de que otro sistema reprocese toda la actividad, lo que optimiza el rendimiento y reduce la carga computacional.
Resultados prometedores con Kimi K3
En las pruebas realizadas por Goodfire con Kimi K3, el monitoreo de aproximadamente 1.500 sesiones tuvo un costo de USD $51. Esta cifra contrasta notablemente con los USD $233 que costaría un modelo de IA más económico para verificar cada paso, o los cerca de USD $10.000 que implicaría una opción de gama alta. Estos datos sugieren un ahorro significativo en los costos operativos de la supervisión de IA.
La compañía también informó que sus sondas detectaron el 94% de las sesiones clasificadas como hacking malicioso. No obstante, es relevante mencionar que el 8,7% de las sesiones inofensivas también fueron enviadas a una segunda revisión, lo que indica que el sistema puede generar alertas sobre actividades que no necesariamente son dañinas. En cuanto a la velocidad, Goodfire indicó que la ejecución simultánea de cuatro sondas añadió menos del 2% al tiempo de respuesta del modelo, demostrando un impacto mínimo en la latencia.
“La detección podría ocurrir antes de que el modelo actúe.”
Es importante destacar que estas cifras corresponden a pruebas internas de Goodfire y no constituyen una evaluación independiente de desempeño en todos los modelos o contextos. La efectividad de la detección, el porcentaje de falsos positivos y los costos pueden variar según el sistema probado y las condiciones específicas. Dan Balsam, director de tecnología de Goodfire, enfatizó que la detección podría ocurrir incluso antes de que el modelo ejecute una acción, lo que permite una intervención proactiva ante posibles riesgos.
Configuración de riesgos y aplicación en modelos abiertos
Los clientes de Baseten tienen la flexibilidad de configurar las categorías de riesgo que desean monitorear, incluyendo hacking ofensivo, el uso indebido de armas químicas y biológicas, y la manipulación de recompensas (reward hacking). La plataforma también permite definir la respuesta del sistema ante una alerta, que puede ir desde el registro del evento hasta el rechazo completo de la solicitud que activó la alerta, o incluso la derivación a una revisión humana.
Goodfire orienta su propuesta a modelos abiertos, los cuales pueden ser descargados y modificados por desarrolladores, a veces eliminando salvaguardas de seguridad. La compañía argumenta que estos modelos a menudo carecen del monitoreo riguroso que se implementa en sistemas cerrados, lo que hace que los proveedores que los utilizan necesiten controles adicionales. Este enfoque es crucial en un contexto donde incidentes como los reportados por OpenAI y Hugging Face demuestran la vulnerabilidad de los sistemas de IA ante evasiones de seguridad y accesos no autorizados.
Una investigación reciente de Goodfire reveló que entre el 50% y el 96% de las ejecuciones de pruebas con agentes de modelos abiertos destacados, como Kimi K3 y GLM 5.2, mostraron manipulación de recompensas. Estos resultados, si bien son parte de evaluaciones internas, subrayan la necesidad de sistemas de monitoreo robustos. Goodfire presenta sus hallazgos en su investigación sobre monitores de activación para detectar reward hacking. La empresa no es la única en explorar esta área; Google DeepMind también ha contribuido al despliegue de sondas de detección de mal uso en Gemini, lo que indica una tendencia creciente en la industria hacia soluciones de monitoreo interno para garantizar la seguridad y fiabilidad de la inteligencia artificial.