Mistral AI ha lanzado Voxtral 3, una familia de modelos y herramientas diseñadas para construir agentes de voz con la capacidad de escuchar, procesar solicitudes y responder en conversaciones en tiempo real. Esta propuesta integra en un único flujo la transcripción de audio, el razonamiento, el uso de herramientas externas y la generación de voz, yendo más allá de la simple conversión de audio a texto o la lectura de respuestas preescritas.
Componentes clave de Voxtral 3
El conjunto Voxtral 3 se compone de elementos fundamentales que trabajan en sinergia:
- Voxtral Small Transcribe 3: Un modelo avanzado de voz a texto capaz de transcribir audio en más de 50 idiomas, lo que facilita la interpretación de solicitudes en diversas lenguas.
- Voxtral Mini TTS 3: Un modelo de texto a voz que genera audio en más de 35 idiomas y 50 dialectos. Destaca por su capacidad de adaptación emocional, permitiendo ajustar el carácter expresivo de la voz generada.
- SDK de agentes de voz basado en LiveKit: Este kit de desarrollo de software proporciona a los desarrolladores una estructura sólida para conectar las capacidades de escucha, respuesta y acción durante la interacción.
La principal innovación que Mistral AI subraya radica en la posibilidad de que el agente no solo reconozca las palabras del usuario, sino que también razone sobre la solicitud y utilice herramientas externas mientras la conversación se mantiene activa. Esto significa que una interacción puede trascender la simple entrega de una respuesta hablada, permitiendo al sistema consultar servicios externos, como parte de una tarea solicitada por voz.
Este tipo de producto está dirigido a equipos que desean integrar interfaces habladas en sus servicios, aunque el anuncio inicial no detalla sectores específicos, clientes o resultados de uso concretos. En la práctica, esta arquitectura unifica etapas que a menudo se presentan de forma aislada en experiencias de voz: la captura y transcripción de lo dicho, la determinación de la respuesta adecuada y la producción de una contestación audible. El SDK añade un canal para integrar herramientas externas, ampliando las funcionalidades del agente.
Capacidades multilingües y uso de herramientas
Voxtral Small Transcribe 3 ofrece una amplia cobertura lingüística, transcribiendo audio en más de 50 idiomas. Esta característica es crucial para que el modelo pueda interpretar solicitudes expresadas en diversas lenguas, aunque la información disponible no especifica la precisión para cada idioma ni las condiciones de uso en escenarios particulares.
Por otro lado, Voxtral Mini TTS 3 genera voz en más de 35 idiomas y 50 dialectos, incorporando una función de adaptación emocional. Esta característica permite modular el carácter expresivo de la voz generada, aunque el anuncio no proporciona detalles sobre las emociones disponibles, cómo se controlan o si todas las opciones funcionan de manera idéntica en cada idioma y dialecto.
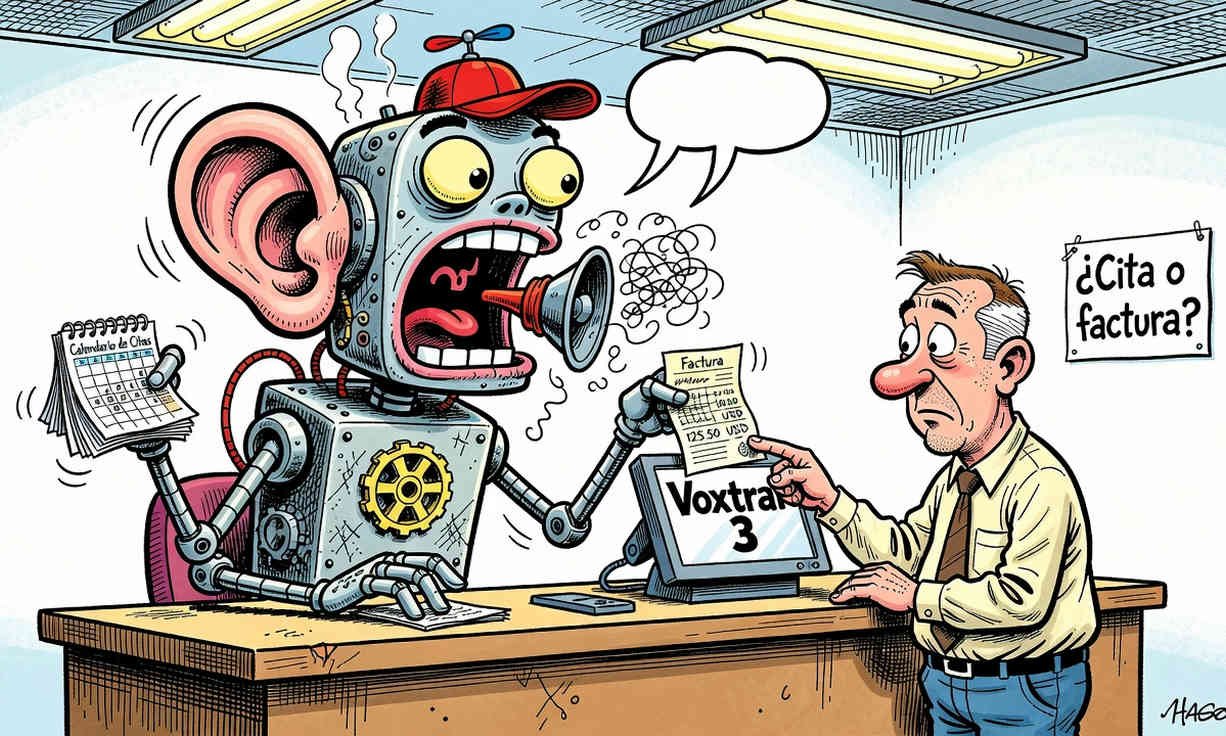
El uso de herramientas externas es un pilar fundamental de la propuesta de Mistral AI. La compañía cita ejemplos como la reserva de citas y la consulta de facturas durante una conversación en vivo. En estos casos, el agente podría pasar de entender una petición a interactuar con un sistema conectado, si bien la empresa no identifica servicios específicos ni describe los permisos o pasos técnicos necesarios para cada integración.
El SDK basado en LiveKit proporciona el marco de desarrollo para ensamblar estas capacidades en agentes de voz. Según la fuente del lanzamiento, The Decoder, el conjunto representa una pila completa para este tipo de agentes, una descripción que resume el alcance de los componentes presentados, pero que no constituye una evaluación independiente sobre su rendimiento, facilidad de integración o calidad en comparación con otras soluciones del mercado.
Opciones de despliegue y estructura de precios
Mistral AI ha indicado que Voxtral 3 puede ejecutarse en infraestructura propia o utilizarse a través de APIs alojadas en la Unión Europea. La primera opción está pensada para organizaciones que prefieren operar el sistema en sus propios entornos, mientras que la segunda ofrece acceso mediante servicios gestionados en la UE. Ambas alternativas, según la compañía, están orientadas a mantener el control de los datos por parte del usuario.
Este enfoque puede ser relevante para organizaciones que deben tomar decisiones estratégicas sobre dónde procesar información de voz y cómo conectar un agente con sus sistemas existentes. Sin embargo, la información publicada no detalla las condiciones de almacenamiento, los plazos de retención ni las medidas específicas de seguridad y privacidad, lo que impide determinar cómo se gestiona cada dato en todos los modos de implementación.
El precio de la transcripción se anuncia a partir de USD $0,0035 por minuto. Es importante destacar que esta cifra corresponde únicamente al servicio de transcripción y no debe interpretarse como el costo total de un agente que también genere voz, utilice herramientas o acceda a una API alojada. La información disponible no proporciona tarifas completas para esos otros componentes.
El lanzamiento de Voxtral 3 lo posiciona como una oferta integrada, aunque aún quedan preguntas importantes para los potenciales adoptantes, como su comportamiento en conversaciones reales, la latencia que puede alcanzar y los costos asociados a una solución completa. Por ahora, lo confirmado es la combinación de modelos de transcripción y síntesis, el SDK basado en LiveKit, los ejemplos de uso con sistemas externos y las alternativas de despliegue que Mistral AI ha descrito.