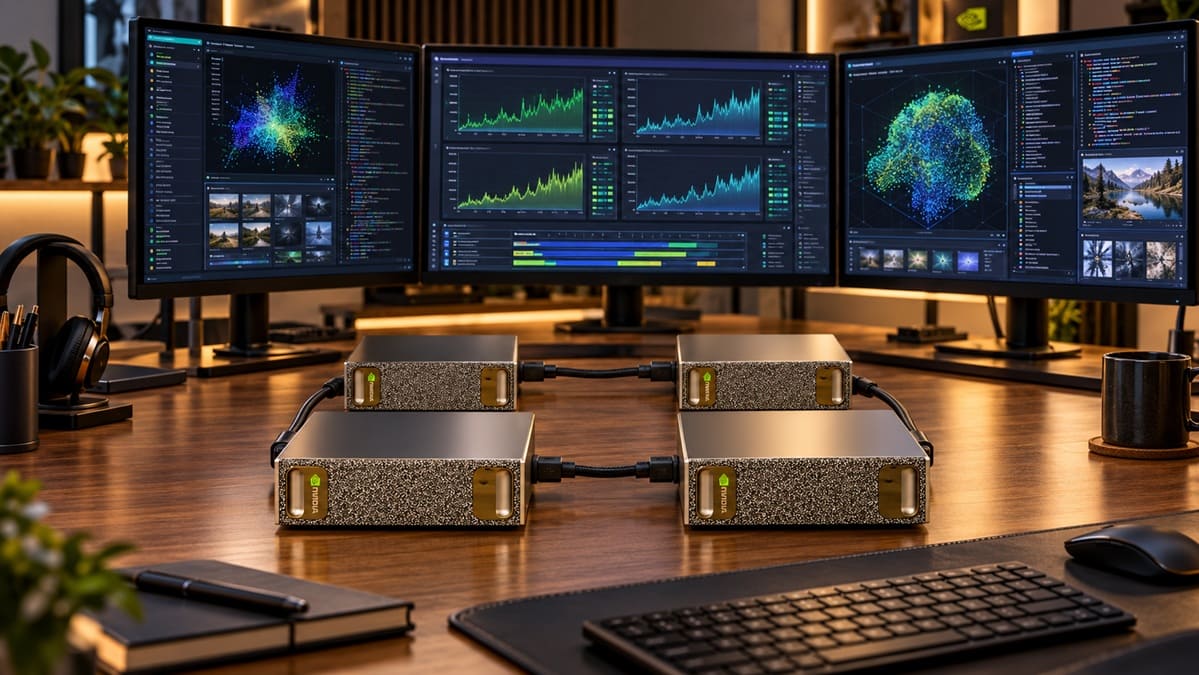
La inteligencia artificial avanza a pasos agigantados, y cada vez vemos más ejemplos de su aplicación en entornos que van más allá de los gigantes tecnológicos. Recientemente, el analista Patrick Moorhead ha conseguido un hito impresionante: ejecutar localmente el modelo DeepSeek V4.1-Flash en un clúster doméstico de cuatro unidades NVIDIA DGX Spark, alcanzando un pico agregado de 494 tokens por segundo.
Este logro nos abre la puerta a imaginar un futuro donde la IA de gran escala no solo reside en la nube, sino que puede ser desplegada y gestionada en infraestructuras más cercanas, incluso en lo que podríamos considerar un entorno profesional local.
¿Qué hay detrás de estos 494 tokens/s?
Es fundamental entender que esta cifra, aunque impresionante, tiene su contexto. Los 494 tokens/s representan el rendimiento agregado del sistema cuando procesa 32 peticiones simultáneas de código. Para una única petición, la velocidad se reduce a unos 96 tokens/s en código y 58 tokens/s en prosa. Esto nos indica que el sistema está optimizado para la concurrencia, es decir, para atender a múltiples usuarios o tareas al mismo tiempo, más que para una interacción ultrarrápida con un solo usuario.
Cada DGX Spark integra un SoC GB10 Grace Blackwell, que combina una CPU Arm de 20 núcleos y una GPU Blackwell, junto con 128 GB de memoria unificada. Al unir cuatro de estas unidades, se obtiene una capacidad total de 512 GB de memoria, suficiente para alojar los aproximadamente 476 GB que requiere DeepSeek V4.1-Flash.
La clave: la arquitectura Mixture-of-Experts (MoE)
¿Cómo es posible manejar un modelo de 552.000 millones de parámetros con esta configuración? La respuesta está en la arquitectura de DeepSeek V4.1-Flash, que utiliza un enfoque conocido como Mixture-of-Experts (MoE). Esto significa que, aunque el modelo es enorme, no todos sus parámetros están activos en cada momento. De hecho, solo se activan unos 8.000 millones de parámetros durante la entrada y 16.000 millones durante la generación. Esta estrategia reduce drásticamente la carga computacional necesaria por cada token, haciendo viable su ejecución en este tipo de hardware.
Además, DeepSeek incorpora otras optimizaciones como Compressed Sparse Attention 2, cuantización FP4 y SWA Bounded Replay, que contribuyen a su eficiencia y a la reducción del consumo de memoria, especialmente en la caché KV.
Conectividad y costes: la realidad de la IA local avanzada
Un aspecto interesante de esta configuración es la conexión entre los cuatro nodos. Moorhead optó por una conexión directa en anillo utilizando las interfaces ConnectX-7 de cada DGX Spark, evitando así el coste y la complejidad de un switch Ethernet de alta velocidad. Esta topología, aunque puede introducir latencias en la comunicación entre nodos no adyacentes, demuestra ser efectiva si el software de inferencia distribuye bien las operaciones y minimiza las sincronizaciones.
DeepSeek V4.1 Flash on 4 x Sparks with no optical router. Deets in the photos. pic.twitter.com/OWbfkJy2HO
— Patrick Moorhead (@PatrickMoorhead) October 5, 2026
En cuanto al consumo energético, es importante aclarar que las unidades DGX Spark tienen un TDP de 140W para el GB10 y una fuente de alimentación de 240W. Esto significa que el consumo total del clúster es mucho menor de lo que algunas informaciones erróneas han sugerido, situándose por debajo de los 1.000W para las cuatro unidades. Esto hace que la infraestructura sea más viable para una instalación local.
Sin embargo, el coste inicial sigue siendo una barrera significativa. Con cada DGX Spark rondando los 7.000-9.000 dólares, el desembolso total para un sistema de cuatro unidades se sitúa entre 28.000 y 36.000 dólares. A esto hay que sumarle los accesorios como cables y la infraestructura de soporte. Claramente, no es una configuración para el usuario doméstico promedio, sino una pequeña infraestructura profesional que, por sus características, puede instalarse fuera de un centro de datos tradicional.
Este experimento subraya que la IA local tiene un potencial enorme para escalar más allá de un único PC. Nos demuestra que es posible mantener modelos de lenguaje masivos en memoria y atender múltiples solicitudes simultáneas en un entorno controlado, ofreciendo ventajas en privacidad de datos y reducción de costes operativos a largo plazo.